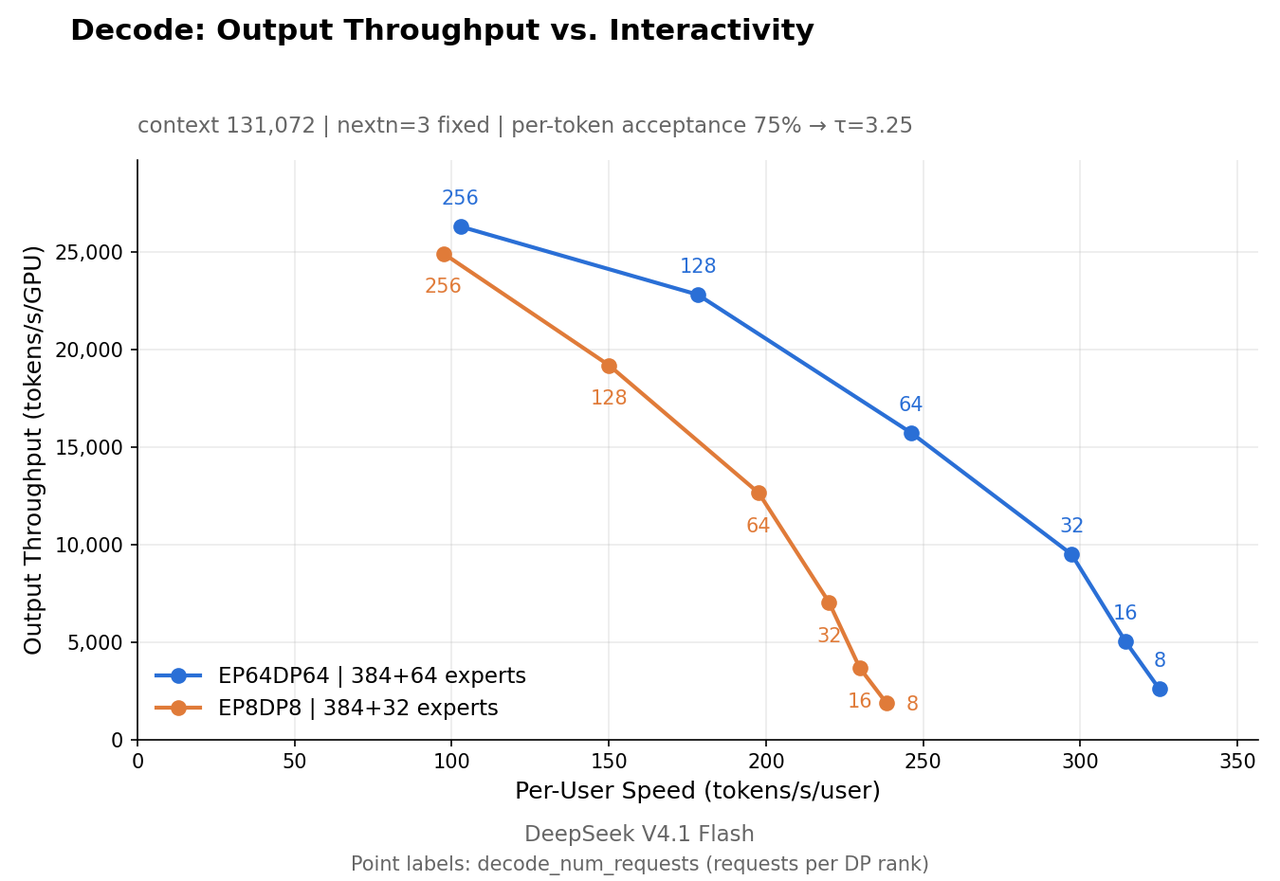
DeepSeek-V4.1-Flash 架构分析
DeepSeek-V4.1-Flash(以下简称 V4.1)的技术报告标题就叫“Pushing the Limits of KV Cache Compression”,而事实上这个模型的架构设计也是为了应对动辄几百 K 上下文的 Agent 场景恐怖的 kvcache size。从效果上看,V4.1 的运行时每 token kvcache(全局)仅为 890 bytes,是 DeepSeek-V4-Flash 的 1/4;而通过 SWA Bounded Replay 机制,V4.1 的每 token 持久化 kvcache 更是低至 DeepSeek-V4-Flash 的 1/8。
为了实现这样大幅的 kvcache 压缩,V4.1 对模型架构做了比较复杂的设计,包括整体计算流程和层内 Attention 实现在内的具体细节已经和几年前的 Decoder-Only LLM 有了巨大的区别。然而万变不离其宗,Attention 的计算公式依然是 \(\text{Softmax}(\frac{QK^{\top}}{\sqrt{d_K}})V\),各种各样的压缩技术本质上是在解决“\(Q\) 怎样和更少的 \(KV\) 进行 Attention 计算”。从这个视角出发,分析 V4.1 模型架构主要是研究每一层的 \(Q\) 都在和哪些 \(KV\) 做计算。
CED(Causal-Encoder-Decoder)架构
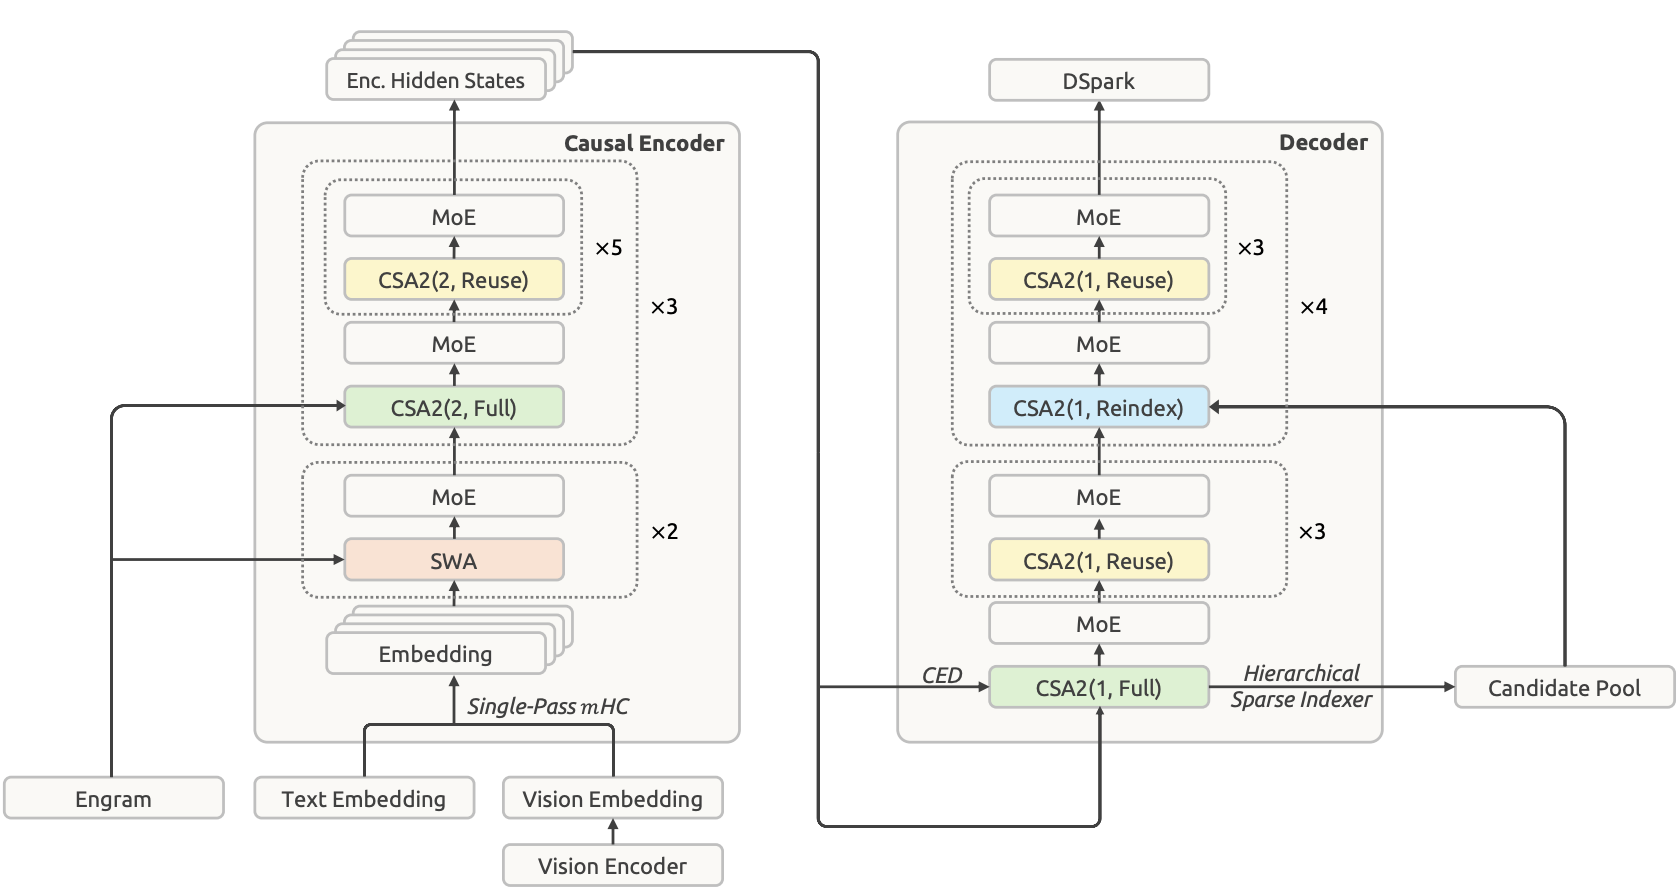
作为一个 VLM 模型,V4.1 的 vision 没有什么特别的地方,细节都在 text。
不同于传统 LLM,V4.1 将 40 层模型分为 20 层 Causal Encoder 和 20 层 Decoder,除前两层是纯 SWA 外,每一层都是全局 Attention 和 SWA 的混合架构,即与本层 \(Q\) 进行 Attention 计算的是经 indexer 从全局 kv 中选取的 selected kv 与 SWA kv 拼接后得到的 kvcache。
对于 Decode 来说,CED 架构和 40 层 Decoder-Only LLM 的计算过程没有区别,差异主要体现在 Prefill。在 CED 架构下,Prefill 过程只在前 20 层的 Causal Encoder 中计算全局 kvcache,后 20 层 Decoder 的全局 kvcache 则全部由第 20 层输出的 hidden states 经由每个 Decoder 自己的 projection weights 投影得到。SWA 的 kvcache 则仍保持逐层计算,对于输入长度远大于 SWA window size 的场景,这可以看作把 Prefill 的计算量砍半。
后面我们会看到,在实际落地中,V4.1 只有第 21 层真正从第 20 层的输出投影得到了全局 kvcache,第 22-40 层则通过 CSA2 的设计复用了这份全局 kvcache。
CSA2(Compressed Sparse Attention 2)
除了全局 kv 与 SWA kv 的拼接,每层内部的 Attention 架构还有其他细节。
图 1 中可以看到,前两层 Causal Encoder 只有 SWA 的 kvcache 参与计算。后续所有层的 CSA2(ratio, mode) 表示这一层 CSA2 的压缩率(即多少个 token 生成一条 kvcache,q 是不被压缩的)和不同模式:
- Full:全局 KV、Indexer 的 QK、Top-K 全部在本层重计算;
- Reindex:全局 KV、Indexer 的 K 复用最近 Full Mode 层的结果,Indexer 的 Q 和 Top-K 依然在本层重计算;
- Reuse:全局 KV 来自最近的 Full Mode 层,Top-K 来自最近的 Full Mode 或 Reindex Mode 层;
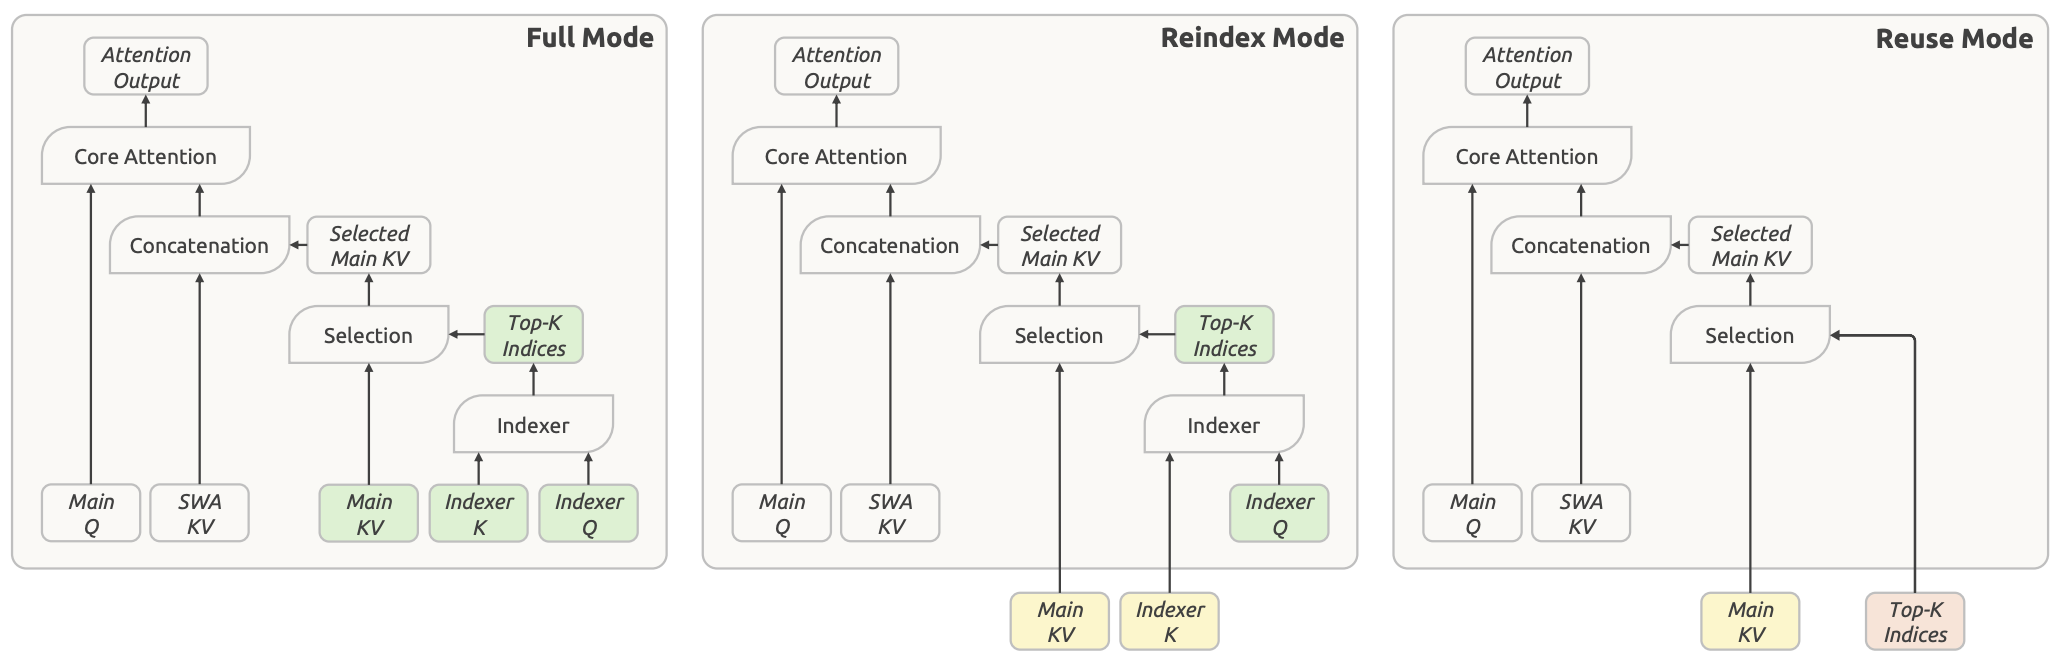
结合图 1 可知,V4.1 中只有 4 层真正计算了全局 kvcache,且其中 Causal Encoder 的 3 层压缩率为 2,第 21 层是唯一计算全序列长度 kvcache 的层。
此外,图 1 中还存在名为 Hierachical Sparse Indexer 的机制,即第 21 层的 Full Mode CSA2 从全局 kvcache 中挑选一个共享的候选位置 pool,后续 Reindex 模式的 CSA2 不再从全局 kvcache 中选取 Top-K,而是从固定大小的候选池中选取。
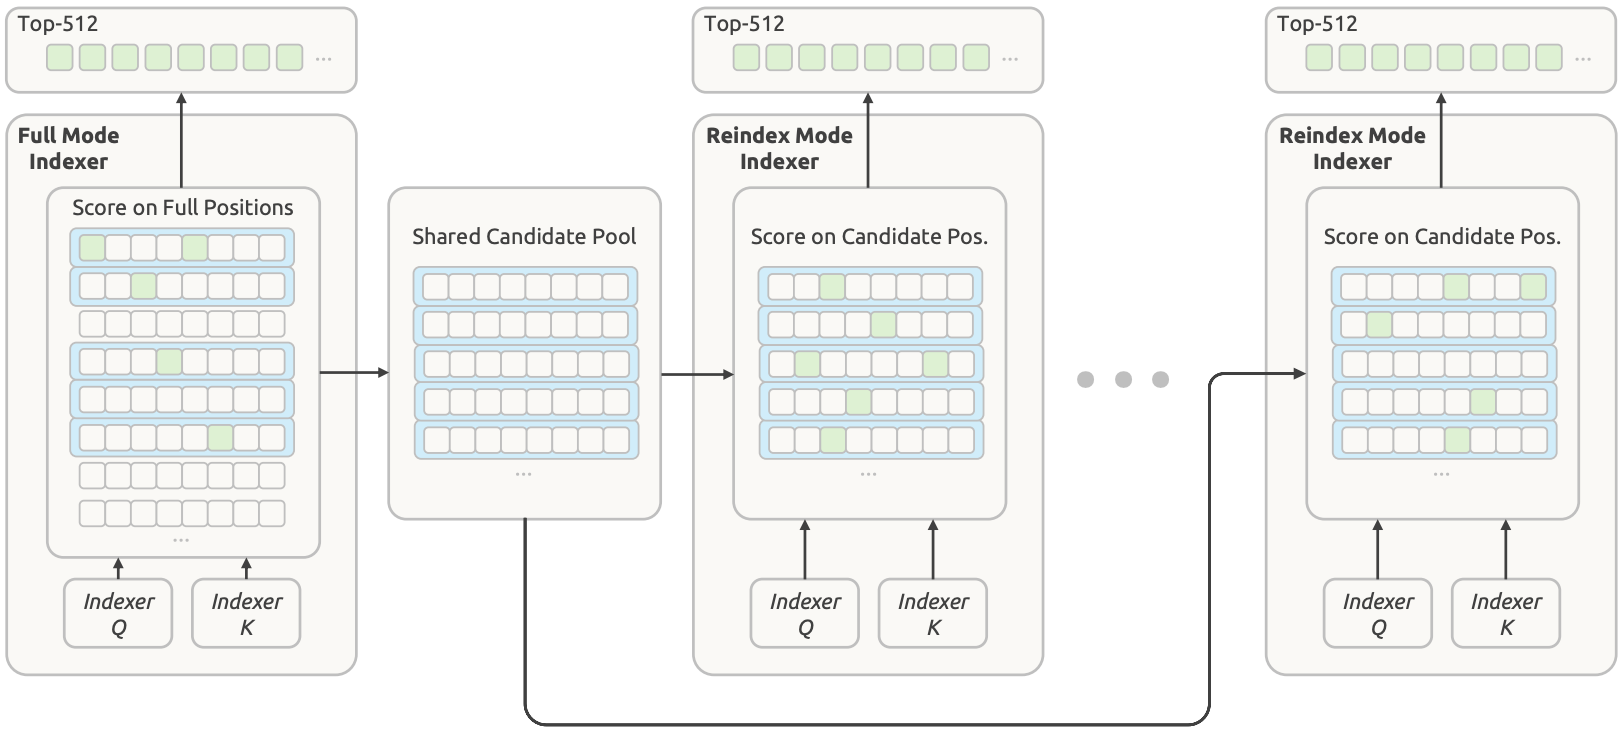
这种设计又进一步使 Sparse attention 中 indexer 环节的耗时不再随输入长度而增长,也是面向长上下文的一种优化技术。
mHC
原始的 transformer block 只有恒等和残差两条分支,一个 token 的表征维度是 \(X\in\mathbb{R}^{1\times d}\),mHC 把每个 token 扩展为 \(X\in\mathbb{R}^{n\times d}\),然后对于 attention 或 moe 对应的分支先投影回 \(\mathbb{R}^{1\times d}\) 再计算,本质是希望在不增大 attention/moe 计算量的条件下加强表达能力,计算公式为:
\[X_{l+1}=B_lX_l+C_l\mathcal{F}(A_{l-1}X_l),\qquad (A_l,B_l,C_l)=\mathcal{H}(X_l)\]
其中 \(A\in\mathbb{R}^{1\times n},B\in\mathbb{R}^{n\times n},C\in\mathbb{R}^{n\times 1}\) 是由 \(X_l\) 预测的逐 token 系数。\(A_{l-1}X_l\) 的这个错位设计被 V4.1 称为 Single-Pass mHC,目的是让 input mixing 不必等待当前系数预测完成,便于进行 kernel fusion。
从推理性能的角度来说其实并不关键,虽然增加了若干分支,但进入 attention 与 moe 的分支依然只有一个,所以几乎不影响推理的计算量。
Engram
V4.1 在第 2 层、第 15 层两个位置加入了 Engram,设计这个结构的初衷是希望通过一个巨大的静态表将固定搭配、实体名称和静态常识等内容涵盖其中,从而将主干网络的 attention 和 moe 从死记硬背中解放出来投入到推理中。
它的落地形态表现为在 attention 与 moe 之前新增的一个流程:
- 2、3、4-gram 分别将当前位置(Prefill 中则是所有位置)和前若干个 token 通过确定性的哈希映射,以 \(O(1)\) 的时间复杂度直接从 196B 的 Engram 表中拉取对应的静态 embedding 向量;
- 这些 embedding 经过 concat 得到记忆向量 \(e_t\),对 \(e_t\) 分别进行投影得到 \(k_t=W_ke_t\) 与 \(v_t=W_ve_t\);
- 通过本层输入的 hidden states \(h_t\) 计算静态记忆与当前语境的相关度,得到门控系数(标量):
\[\alpha_t=\text{Sigmod}(\frac{\text{RMSNorm}(h_t)^\top\text{RMSNorm}(k_t)}{\sqrt{d}})\]
- \(\alpha_t\) 与 \(v_t\) 进行标量缩放后再加回到 \(h_t\)。
下图是 Engram 的原始版本,它多对 \(\alpha_tv_t\) 做了一次 conv1d,而 V4.1 的技术报告声称这个卷积的推理开销大于它能得到的收益,所以将其去掉了。
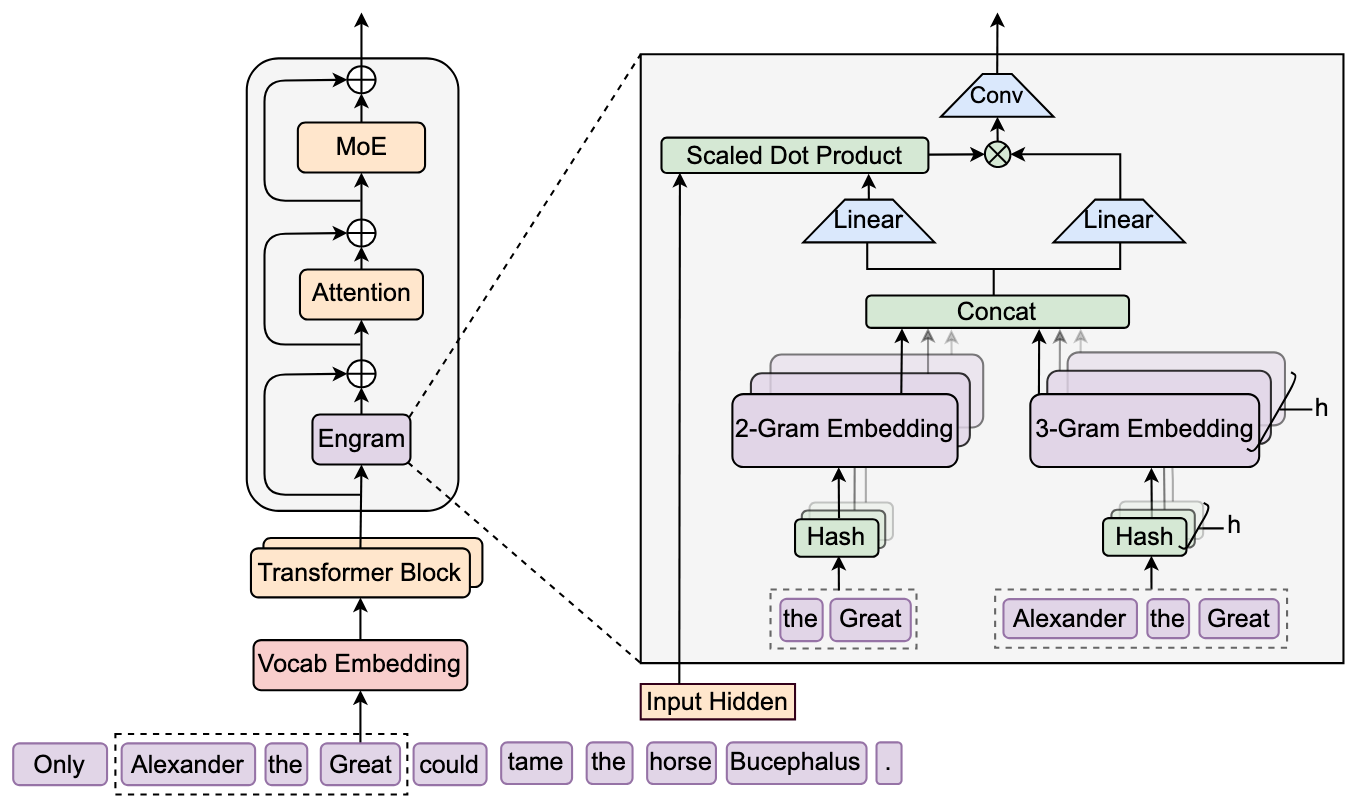
Engram 的哈希、查表、点积、标量缩放等操作对于推理来说基本上也是 0 成本了,并没有大量的 weights loading 或大规模 GEMM,而且哈希的输入仅仅是 token ID 本身,所以 embedding 的加载、拼接、投影还可以在所有 token 进入计算之前就异步处理。
SWA Bounded Replay
前面提到 V4.1 只有 4 层存在真正的全局 kvcache,但 SWA kvcache 是每一层都有的。V4.1 的报告中提到:
Despite retaining only \(n_{win}\) KV entries at designated positions, the uncompressed SWA KV cache still incurs a substantial storage overhead, especially in multi-turn conversations with short turns.
报告指出,V4 的部署实践中,SWA KV 几乎占用了持久化 KV 缓存容量的一半,但缓存 SWA KV 的性价比很低,因为它不能像全局 KV 那样在每轮对话中都发挥作用,其生命周期通常是分钟级别的。
而另一方面,SWA KV 未命中的代价又是无法接受的,因为虽然每一层 SWA KV 的长度仅有 \(n_{win}\),意味着本层输入的 hidden states 长度也只需 \(n_{win}\),但不要忘记每一行 hidden states 都是该行对应的 Q 与该行前 \(n_{win}\) 行 KV 进行 Attention 计算得到的, 所以为了输出长度为 \(n_{win}\) 的 hidden states,上一层的 SWA KV 长度必须是 \(2n_{win}\)。
这就是 SWA 的感受野(Receptive Field)问题,最终导致为了计算出第 40 层的 \(n_{win}\) 条 SWA KV,需要在第一层输入 \(40n_{win}\) 个 token 重新进行 Prefill,“whose cost proved prohibitive in production deployments.”
V4.1 的解法是不再往前找 \(n_{win}\) 条 KV,而是直接取最后 \(n_{win}\) 个 token 做 40 层 self-attention。由于全局 KV 的存在,这样做并不会明显影响模型回答质量,但可以把 SWA KV 未命中而要重新 Prefill 的 token 数量从 \(40n_{win}\) 减少到 \(n_{win}\) 个。报告中的解释是:
prior work (Chen et al., 2025) has shown that the actual effective receptive field of SWA is much smaller than the theoretical \(n_{win}\times L/2\).
总结
V4.1 在架构上与早期纯 Decoder Transformer Block 组成的 LLM 相比,已经有了非常复杂的改进,这些改进主要体现在对 Attention 计算量与 KV cache 存储压力的极大减少。不过 DeepSeek 在这一代依旧延续了 MLA 的主干,并没有采用线性注意力,Moe 部分也保持了比较传统的共享专家+路由专家设计。
V4.1 的技术报告中还写了一些实际部署的优化方案,比如 DSpark 和 FP4 kvcache,这些技术和主干模型的架构设计一起带来了惊人的推理吞吐,对于 Infra 从业人员而言又是一份不得不品鉴的艺术。